# Camino Mínimo
[toc]
## Problemas de caminos mínimos
- Único origen - único destino: Determinar un camino mínimo entre dos vértices específicos.
- Único origen - múltiples destinos: Determinar caminos mínimos desde un vértice a todos los demás vértices del grafo.
- Múltiples orígenes - múltiples destinos: Determinar caminos mínimos entre cada par de vértices del grafo.
- Lema 1: En un digrafo $G = (V, X)$, si $COLA$ contiene a los vértices $v_1$ a $v_r$, se cumple que $\text{dist}[v_1] + 1 \geq \text{dist}[v_r]$ y $\text{dist}[v_i] \leq \text{dist}[v_{i+1}]$ para todo $i$ de 1 a $r-1$.
- Corolario 1: Si el vértice $u$ ingresa a $COLA$ antes que el vértice $w$, en todo momento se cumple que $\text{dist}[u] \leq \text{dist}[w]$.
- Lema 2: Se mantiene que $\text{dist}[u] \geq d(v, u)$ para todo $u$ en $V$, en cualquier momento del algoritmo.
- Teorema 1: El algoritmo BFS calcula $d(v, u)$ para todo $u$ en $V$.
### Algoritmo Dijkstra para caminos mínimos con arcos de peso positivo
- Complejidad: $O(m \ log \ n)$, donde $m$ es el número de aristas y $n$ el número de vértices.
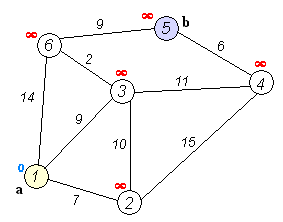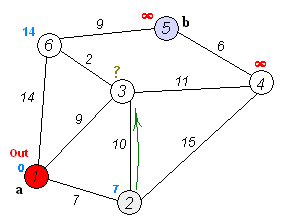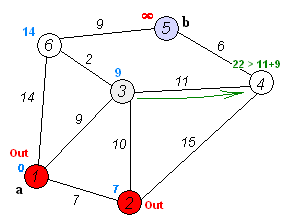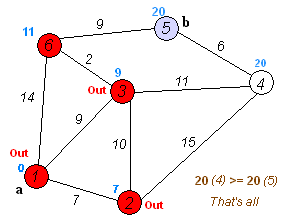
- Lema 3: Al finalizar la iteración $k$, el algoritmo determina un camino mínimo entre $v$ y cada vértice $u$ de $S_k$, con longitud $\pi[u]$.
- Teorema 2: El algoritmo determina el camino mínimo entre el vértice $v$ y el resto de los vértices.
- 
- Código:
```python
import heapq # ColaDePrioridad
def dijkstra(grafo, vertice_inicio):
# Diccionario para almacenar las distancias más cortas a cada vértice
distancias = {vertice: float('infinity') for vertice in grafo}
# La distancia al vértice inicial es 0
distancias[vertice_inicio] = 0
# Cola de prioridad para gestionar los vértices a explorar
cola_prioridad = [(0, vertice_inicio)]
while cola_prioridad:
# Extraer el vértice con la menor distancia
distancia_actual, vertice_actual = heapq.heappop(cola_prioridad)
# Los nodos pueden agregarse varias veces a la cola de prioridad.
# Solo procesamos un vértice la primera vez que lo sacamos de la cola.
if distancia_actual > distancias[vertice_actual]:
continue
# Considerar todos los vecinos adyacentes del vértice actual
for vecino, peso in grafo[vertice_actual].items():
distancia = distancia_actual + peso
# Solo considerar este nuevo camino si es mejor
if distancia < distancias[vecino]:
distancias[vecino] = distancia
heapq.heappush(cola_prioridad, (distancia, vecino))
return distancias
```
### Algoritmo Bellman-Ford para caminos mínimos con arcos de peso positivo o negativo
- Complejidad: $O(n \times m)$, donde $n$ es el número de vértices y $m$ el número de aristas.
Lema 4: Al finalizar la iteración $k$, el algoritmo determina los caminos mínimos de a lo sumo $k$ arcos entre $v$ y los demás vértices.
Teorema 3: El algoritmo determina el camino mínimo entre $v$ y todos los demás vértices, si no hay ciclos de longitud negativa.

- Pseudocódigo:
```pseudocode
BELLMAN-FORD(G,w,s)
INITIALIZE-SINGLE-SOURCE(G,s)
para i=1 hasta |G.V|-1
para cada arista (u,v) en G.E
RELAX(u,v,w)
para cada arista (u,v) en G.E
si v.d > u.d + w(u,v)
devolver falso
devolver verdadero
```
```python
from typing import List, Tuple
def inicializar_fuente(vertices: int, origen: int) -> Tuple[List[float], List[int]]:
# Inicializa distancias y predecesores
distancias = [float('inf')] * vertices
predecesores = [-1] * vertices
distancias[origen] = 0
return distancias, predecesores
def relajar(u: int, v: int, peso: int, distancias: List[float], predecesores: List[int]):
# Relaja la arista y actualiza las distancias y predecesores si encuentra un camino más corto
if distancias[u] + peso < distancias[v]:
distancias[v] = distancias[u] + peso
predecesores[v] = u
def bellman_ford(vertices: int, aristas: List[Tuple[int, int, int]], origen: int) -> bool:
distancias, predecesores = inicializar_fuente(vertices, origen)
# Relajar todas las aristas |V| - 1 veces
for _ in range(vertices - 1):
for (u, v, peso) in aristas:
relajar(u, v, peso, distancias, predecesores)
# Verificar ciclos negativos
for (u, v, peso) in aristas:
if distancias[u] + peso < distancias[v]:
return False # El grafo contiene ciclos de peso negativo
return True # No se encontraron ciclos negativos
```
### Algoritmos matriciales para caminos mínimos entre todos los pares de vértices: Algoritmo de Floyd
- Complejidad: $O(n^3)$, donde $n$ es el número de vértices.
- Lema 5: Al finalizar la iteración k, $d[i][j]$ es la longitud de los caminos mínimos desde $v_i$ a $v_j$ cuyos vértices intermedios son elementos de $\{v_1, \dots, v_k\}$.
- Teorema 4: El algoritmo determina los caminos mínimos entre todos los pares de nodos sin circuitos negativos.
### Algoritmo de Dantzig
- Complejidad: $O(n^3)$ donde $n = |V(G)|$.
- Lema 6: Al finalizar la iteración k, la matriz de kxk generada contiene la longitud de los caminos mínimos en el subgrafo inducido por ${v_1, ..., v_k}$.
- Teorema 5: El algoritmo determina los caminos mínimos entre todos los pares de nodos sin circuitos negativos.
## Relajación
```pseudocode
INITIALIZE-SINGLE-SOURCE(G,s)
para cada vertice v en G.V
v.d = infinito
v.pi = NIL
s.d = 0
```
- observación:
- $d(v)$ significa la distancia minima estimada desde el vertice de origen $s$ hasta el vertice $v$.
- $s.d$ es la distancia desde el vertice de origen $s$ hasta sí mismo.
- $v.\pi$ denota el predecesor de $v$, en el camino más corto desde el vértice de origen.
- La relajación de aristas es una técnica crucial para iterativamente aproximar las distancias más cortas entre los vértices. El procedimiento de relajación aprovecha las propiedades de los caminos más cortos para actualizar las distancias estimadas entre los nodos del grafo, asegurando que cada iteración acerque más a la solución óptima
- El proceso de relajar una arista $(u,v)$ consiste en probar ir por el vertice $u$ para determinar si hacerlo ofrece un camino más corto a $v$ que cualquier camino conocido anteriormente. Si al pasar por $u$ se encuentra un camino más corto a $v$, entonces se actualiza la estimación del camino mínimo para $v$ (representado como $d(v)$) al nuevo valor más bajo $(u.d + w(u,v))$ y se cambia el predecesor de $v$ $(v.\pi)$ a $u$. Este proceso es clave en la dinámica de algoritmos como Dijkstra y Bellman-Ford, donde se busca iterativamente mejorar las estimaciones de la distancia más corta a cada vértice hasta que se alcanzan las distancias óptimas.
```pseudocode
RELAX(u,v,w)
si v.d > u.d + w(u,v) // w de weight, o sea peso.
v.d = u.d + w(u,v)
v.pi = u
```
- Estos algoritmos (dijkstra, bellman, etc) en algo que se diferencian es en que cuantas veces "relajan" cada arista y en que orden lo hacen.
- DDiijkstra's y los algoritmos de camino minimo para grafos aciclicos dirigidos (DAG), relajan cada arista una vez.
- Bellman-Ford relaja cada arista $|V|-1$ veces
### Propiedades de relajación
- Desigualdad triangular: $\forall$arista $(u,v) \in E$, tenemos que $\delta(s,v) \leq \delta(s,u)+w(u,v)$
- Es la misma propiedad que vimos en Analisis Matematico.
- Delta se utiliza para denotar la longitud del camino minimo entre vertices, y es la distancia más corta.
- Propiedad de la cota superior: Siempre tenemos que $d(v) \geq \delta(s,v) \ \forall v \in V$ y una vez que $d(v)$ cumple el valor de $\delta(s,v)$, nunca más vuelve a cambiar.
- Propiedad del no-camino (No-path property nice english btw haHAA): Si no hay un camino desde $s$ a $v$, entonces siempre tenemos que $d(v) = \delta(s,v) = \infty$
- Propiedad de convergencia: si $s$ es el vértice de origen y $u \to v$ es una arista del grafo, entonces tras la relajación si antes de la relajación ya se había conseguido $d(u)=\delta(s,u)$ (o sea la distancia más corta de $s$ a $u$ ya había sido correctamente calculada y guardada en $d(u)$), entonces se garantiza que $d(v)$ no va a ser mayor que $\delta(s,v)$ después de la relajación.
- Propiedad de relajación de camino: si $p = \langle v_0,v_1, \dots, v_k \rangle$ es el camino minimo desde $s = v_0$ a $v_k$ y las aristas de $p$ están relajadas en el orden $(v_0,v_1),(v_1,v_2),\dots,(v_{k-1},v_k)$, entonces $d(v_k) = \delta(s,v_k)$
- Esta propiedad afirma que si tenés un camino $p$ que es el camino mínimo desde un vértice origen $s=v_0$ hasta un vértice destino $v_k$ y si todas las aristas en este camino son relajadas de una manera secuencial, en el orden que aparecen en el camino. Entonces al final de estas relajaciones la distancia estimada $d(v_k)$ almacenada en el vertice $v_k$, será igual a la distancia minima real $\delta(s,v_k)$.
- Propiedad del grafo-predecesor: Una vez que $d(v)=\delta(s,v) \ \forall v \in V$, el subgrafo predecesor es un árbol de camino minimo enraizado en $s$.
## DAGs Grafo acíclico dirigido
- un DAG es un grafo dirigido que no tiene ciclos.
- Esto significa que $\forall v \in V$ no hay un camino directo que empiece y termine en $v$.
- Los DAG aparecen en modelos donde no tiene sentido que un vértice tenga un camino directo a él mismo.
- Ejemplo: si una arista $u \to v$, indica que $v$ es parte de $u$, crear un ciclo $v \to u$ indicaría que $u$ es subconjunto de si mismo y de $v$, lo cual es imposible.
```pseudocode
DAG-SHORTEST-PATHS(G,w,s)
ordenar los vertices de G topologicamente
INITIALIZE-SINGLE-SOURCE(G,s)
para cada vertice u en G.V, de manera ordenada
para cada vertice v en G.adyacente[u]
RELAX(u,v,w)
```
Los DAGs son especialmente importantes en teoría de grafos y algoritmos debido a sus propiedades únicas y aplicaciones prácticas. Aquí algunos puntos teóricos clave:
- **Topología del DAG**: Un DAG permite una ordenación topológica, una secuencia lineal de los vértices tal que para cada arista dirigida $u \to v$, el vértice $u$ aparece antes de $v$ en la ordenación. Esta propiedad es crucial para la planificación y la programación de tareas donde se requiere manejar dependencias.
- **Teoría de los Caminos**: En un DAG, el cálculo de caminos más largos o más cortos se simplifica debido a la ausencia de ciclos, permitiendo el uso de algoritmos más eficientes y directos que en grafos con ciclos.
- **Componentes y Subgrafos**: Cada nodo en un DAG puede actuar como raíz de un subgrafo acíclico, y estos subgrafos pueden analizarse de manera independiente, lo que es útil en áreas como análisis de sistemas y descomposición modular.
#### Aplicaciones
- Planificación de tareas: Los DAGs son utilizados para modelar precedencias entre tareas donde algunas tareas deben ser completadas antes que otras.
- Gestión de dependencias en sistemas: En ingeniería de software, los DAGs son útiles para representar las dependencias entre módulos o componentes.
- Optimización de compiladores: Los DAGs ayudan en la representación de expresiones en compiladores para optimizar el cálculo y reducir redundancias.
- Análisis de redes de flujo: Se utilizan para determinar los caminos de flujo óptimo sin ciclos de retroalimentación.
## Floyd Warshall
- [Video teórico](https://youtu.be/4NQ3HnhyNfQ?si=edjsrVi4bu4CEd05ww)
El algoritmo de Floyd-Warshall es fundamental en el contexto de encontrar caminos más cortos en grafos densos. Aquí algunos aspectos teóricos a destacar:
- **Generalidades**: El algoritmo utiliza una matriz de distancias que se actualiza iterativamente para reflejar el camino más corto entre todos los pares de nodos utilizando cualquier subconjunto de otros nodos como posibles puntos intermedios.
- **Ecuación de Recurrencia**: La operación clave del algoritmo de Floyd-Warshall se puede describir por la recurrencia:
$$
d_{ij}^{(k)} = \min(d_{ij}^{(k-1)}, d_{ik}^{(k-1)} + d_{kj}^{(k-1)})
$$
donde $d_{ij}^{(k)}$ representa la distancia más corta entre los nodos $i$ y $j$ utilizando solo los primeros $k$ nodos como intermedios.
- **Propiedades**: El algoritmo maneja grafos con pesos negativos siempre que no haya ciclos de peso negativo accesibles desde el vértice origen. Esto lo hace adecuado para aplicaciones que incluyen reajustes en la modelación de sistemas económicos y de transportes.
$$
\begin{array}{l}
\text{Asumimos que el grafo es orientado y que no hay ciclos de longitud negativa.} \\
L^0 := L \\
\text{para } k \text{ desde } 1 \text{ a } n \text{ hacer:} \\
\quad \text{para } i \text{ desde } 1 \text{ a } n \text{ hacer:} \\
\quad \quad \text{para } j \text{ desde } 1 \text{ a } n \text{ hacer:} \\
\quad \quad \quad l_{ij}^k := \min(l_{ij}^{k-1}, l_{ik}^{k-1} + l_{kj}^{k-1}) \\
\quad \quad \text{fin para} \\
\quad \text{fin para} \\
\text{fin para} \\
\text{retornar } L^n
\end{array}
$$
- complejidad asintotica en peor/mejor/promedio caso: $O(V^3)$
## Dantzig
- Aclaración: No encontré información acerca de este algoritmo, así que lo que escribo acá va a ser más de lo mismo de lo que hay en las diapos teoricas y practicas.
- Al finalizar la iteración $k-1$ el algoritmo de Dantzig genera una matriz de $k \times k$ caminos minimos en el subgrafo inducido por los vértices $\{v_1,\dots, v_k\}$
- Comentario: un subgrafo inducido de un grafo se define a partir de un conjunto de vértices seleccoinados del grafo original.
- El subgrafo inducido incluye a todos los vértices en este conjunto y todas las aristas del grafo original que conectan pares de vértices dentro de este conjunto.
- Es decir, un subgrafo es inducido si contiene todas las aristas que en el grafo original conectan los vértices seleccionados.
- Ejemplo: si tenés el grafo $G=(V,E)$ y seleccionas un subconjunto de vértices $V' \subseteq V$, el subgrafo inducido por $V'$ es el grafo $G[V']$ que tiene como conjunto de vértices $V'$ y como conjunto de aristas, todas en $E$ que tienen ambos extremos en $V'$
- 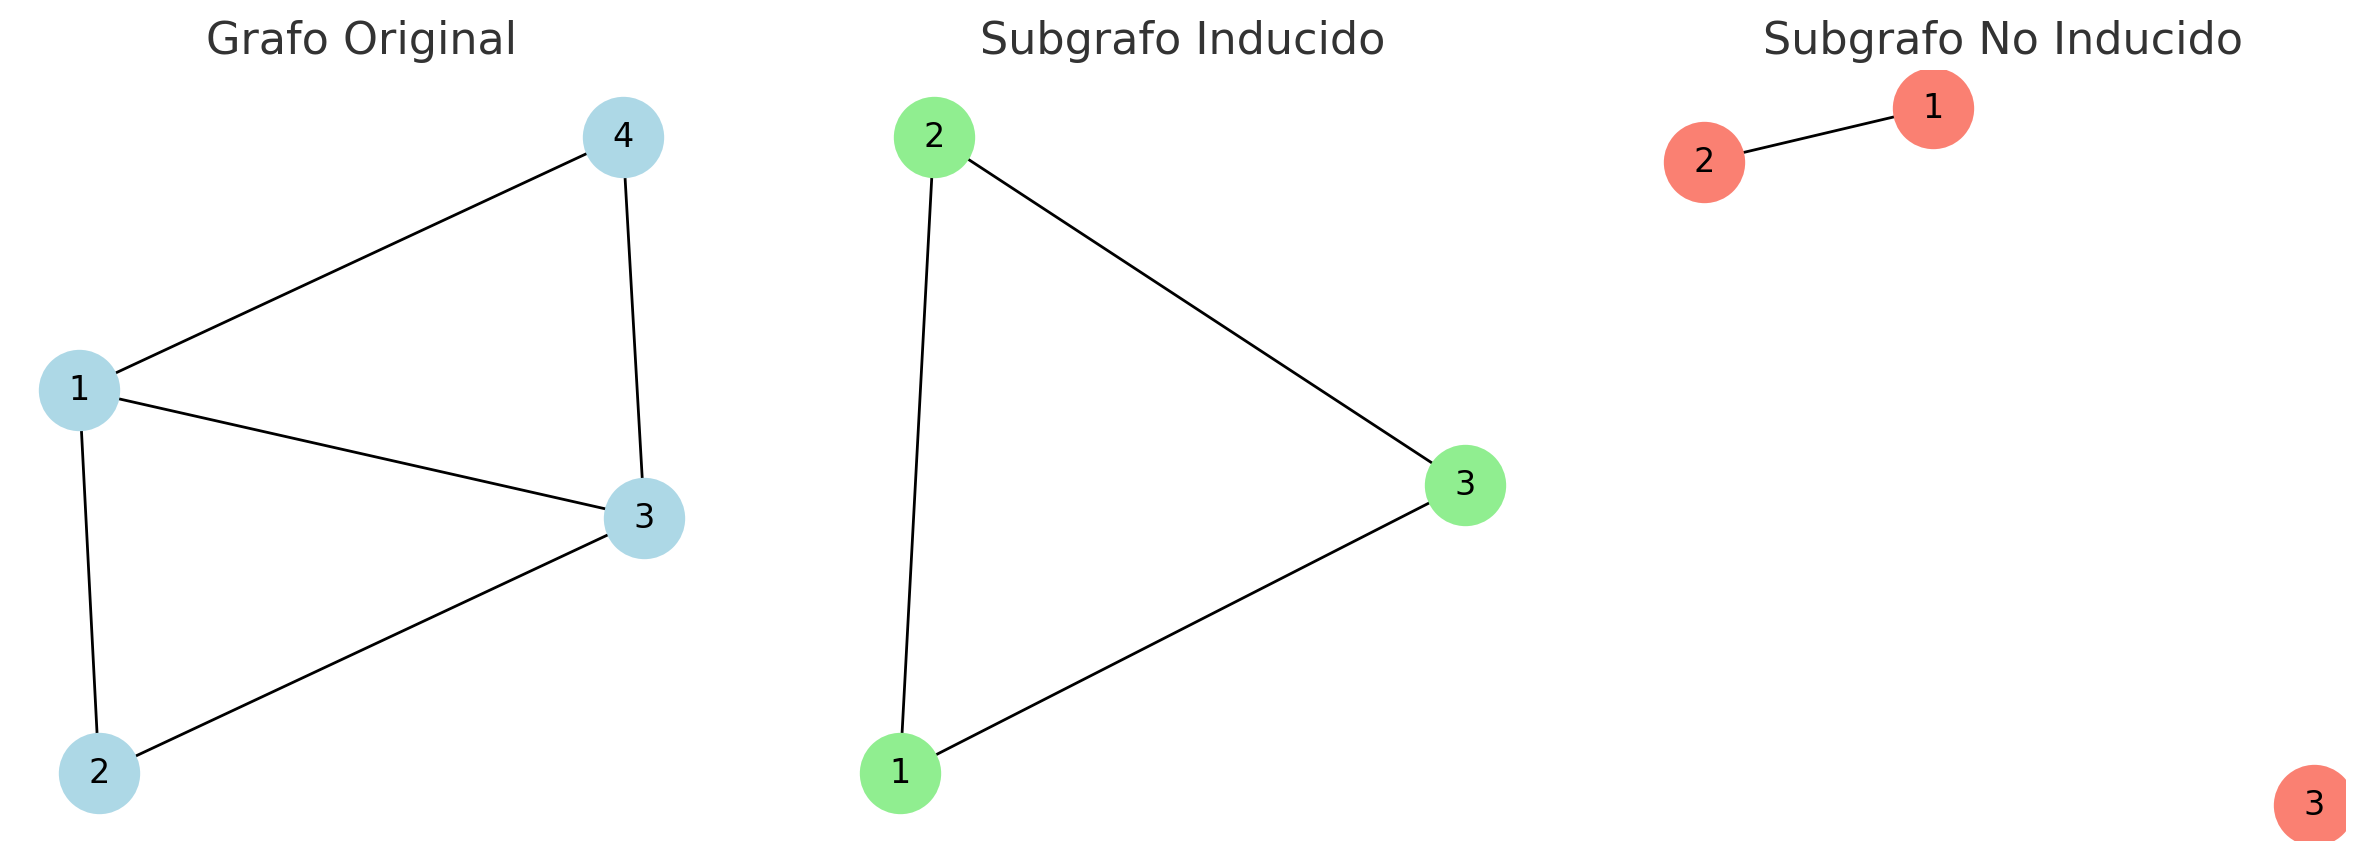
- Subgrafo Inducido: Se formó usando el subconjunto de vértices {1, 2, 3}. Este subgrafo contiene todas las aristas del grafo original que conectan estos tres vértices entre sí, es decir, (1-2, 2-3, 1-3). Esto es un ejemplo de subgrafo inducido porque incluye todas las aristas posibles entre los vértices seleccionados del grafo original.
- Calcula la matriz $L^{k+1}$ a partir de la matriz $L^k$ para $1 \leq i,j \leq k$ como:
$$
L_{i, k+1}^{k+1} = \min_{1 \leq j \leq k} (L_{i,j}^k + L_{j,k+1}^k)
$$
- Actualiza la distancia minima estimada desde el vertice $i$ al vértice $k+1$ considerando todos los vértices hasta $k$ como posibles puntos intermedios.
- Para cada $j$, se calcula la suma de la distancia de $i$ a $j$ y de $j$ a $k+1$ usando las distancias más cortas conocidas hasta la iteración $k$.
- El valor mínimo de estas sumas se convierte en la nueva distancia estimada de $i$ a $k+1$ en la iteración $k+1$.
$$
L_{k+1, i}^{k+1} = \min_{1 \leq j \leq k} (L_{k+1,j}^k + L_{j,i}^k)
$$
- Muy similar acá, actualiza la distancia minima del vértice $k+1$ al vértice $i$.
- Considera todos los vértices $k$ como intermediarios, calculando la suma de las nuevas distancias de $k+1$ de $j$ a $i$ para cada $j$.
$$
L_{i,j}^{k+1} = \min(L_{i,j}^k, L_{i,k+1}^{k+1} + L_{k+1,j}^{k+1})
$$
- Acá actualiza la distancia minima de $i$ a $j$, compara la distancia directa anterior con la nueva ruta potencial que pasa por $k+1$ tomando el camino que pasa por $k+1$ si resulta ser más corto.
- Asumimos que el grafo es orientado. Detecta ciclos de longitud masiva
$$
\begin{array}{l}
\text{Asumimos que el grafo es orientado y que no hay ciclos de longitud negativa inicialmente.} \\
L := \text{matriz de adyacencia del grafo} \\
\text{para } k \text{ desde } 1 \text{ a } n-1 \text{ hacer:} \\
\quad \text{para } i \text{ desde } 1 \text{ a } k \text{ hacer:} \\
\quad \quad L_{i,k+1} := \min(L_{i,j} + L_{j,k+1} \text{ para todo } j \text{ tal que } 1 \leq j \leq k) \\
\quad \quad L_{k+1,i} := \min(L_{k+1,j} + L_{j,i} \text{ para todo } j \text{ tal que } 1 \leq j \leq k) \\
\quad \text{fin para} \\
\quad t := \min(L_{k+1,i} + L_{i,k+1} \text{ para todo } i \text{ tal que } 1 \leq i \leq k) \\
\quad \text{si } t < 0 \text{ entonces:} \\
\quad \quad \text{retornar "Hay ciclos de longitud negativa"} \\
\quad \text{fin si} \\
\quad \text{para } i \text{ desde } 1 \text{ a } k \text{ hacer:} \\
\quad \quad \text{para } j \text{ desde } 1 \text{ a } k \text{ hacer:} \\
\quad \quad \quad L_{i,j} := \min(L_{i,j}, L_{i,k+1} + L_{k+1,j}) \\
\quad \quad \text{fin para} \\
\quad \text{fin para} \\
\text{fin para} \\
\text{retornar } L
\end{array}
$$
### Lema:
- Al finalizar la iteración $k-1$ del algoritmo de Dantzig, la matriz $k \times k$ generada contiene la longitud de caminos mínimos en el subgrafo inducido por los vértices $\{v_1, \dots, v_k\}$
### Teorema
- El algoritmo de Dantzig determina los caminos mínimos entre **todos** los pares de vértices de un **grafo orientado sin ciclos**.
- ¿Cuál es la complejidad del algoritmo de Dantzig?
- $O(V^3)$
- ¿Que diferencia tiene con el algoritmo de floyd?
- Orden de iteración
- Floyd Warshall actualiza las distancias considerando todos los pares de vértices en cada paso.
- Y en Dantzig podría seguir un orden diferente o una estrategia de actualización especifica.
- TBD
## Tabla de algoritmos de camino minimo
| Algoritmo | BFS | Dijkstra | Bellman-Ford | Floyd-Warshall |
| -------------------------- | --------------------- | ------------------- | ------------------ | ------------------ |
| Complejidad | O(V + E) | O((V + E) log V) | O(VE) | O(V³) |
| Tamaño recomendado del grafo| Grande | Grande/Mediano | Mediano/Pequeño | Pequeño |
| ¿Bueno para todos los pares de caminos más cortos (APSP)? | Solo funciona en grafos no ponderados | Ok | Malo | Sí |
| ¿Puede detectar ciclos negativos? | No | No | Sí | Sí |
| Camino más corto (SP) en grafo con aristas ponderadas | Respuesta incorrecta | Mejor algoritmo | Funciona | Malo en general |
| Camino más corto (SP) en grafo con aristas no ponderadas | Mejor algoritmo | Ok | Malo | Malo en general |
*Referencia: Competitive Programming 3, P. 161, Steven & Felix Halim
*
- asdasd